Weight Initialization (가중치 초기화)
Weight Initialization은 Gradient Vanishing/Exploding Problem을 개선하기 위해 연구된 방법.
Activation Function과 궁합이 맞는 방법들이 나뉨.
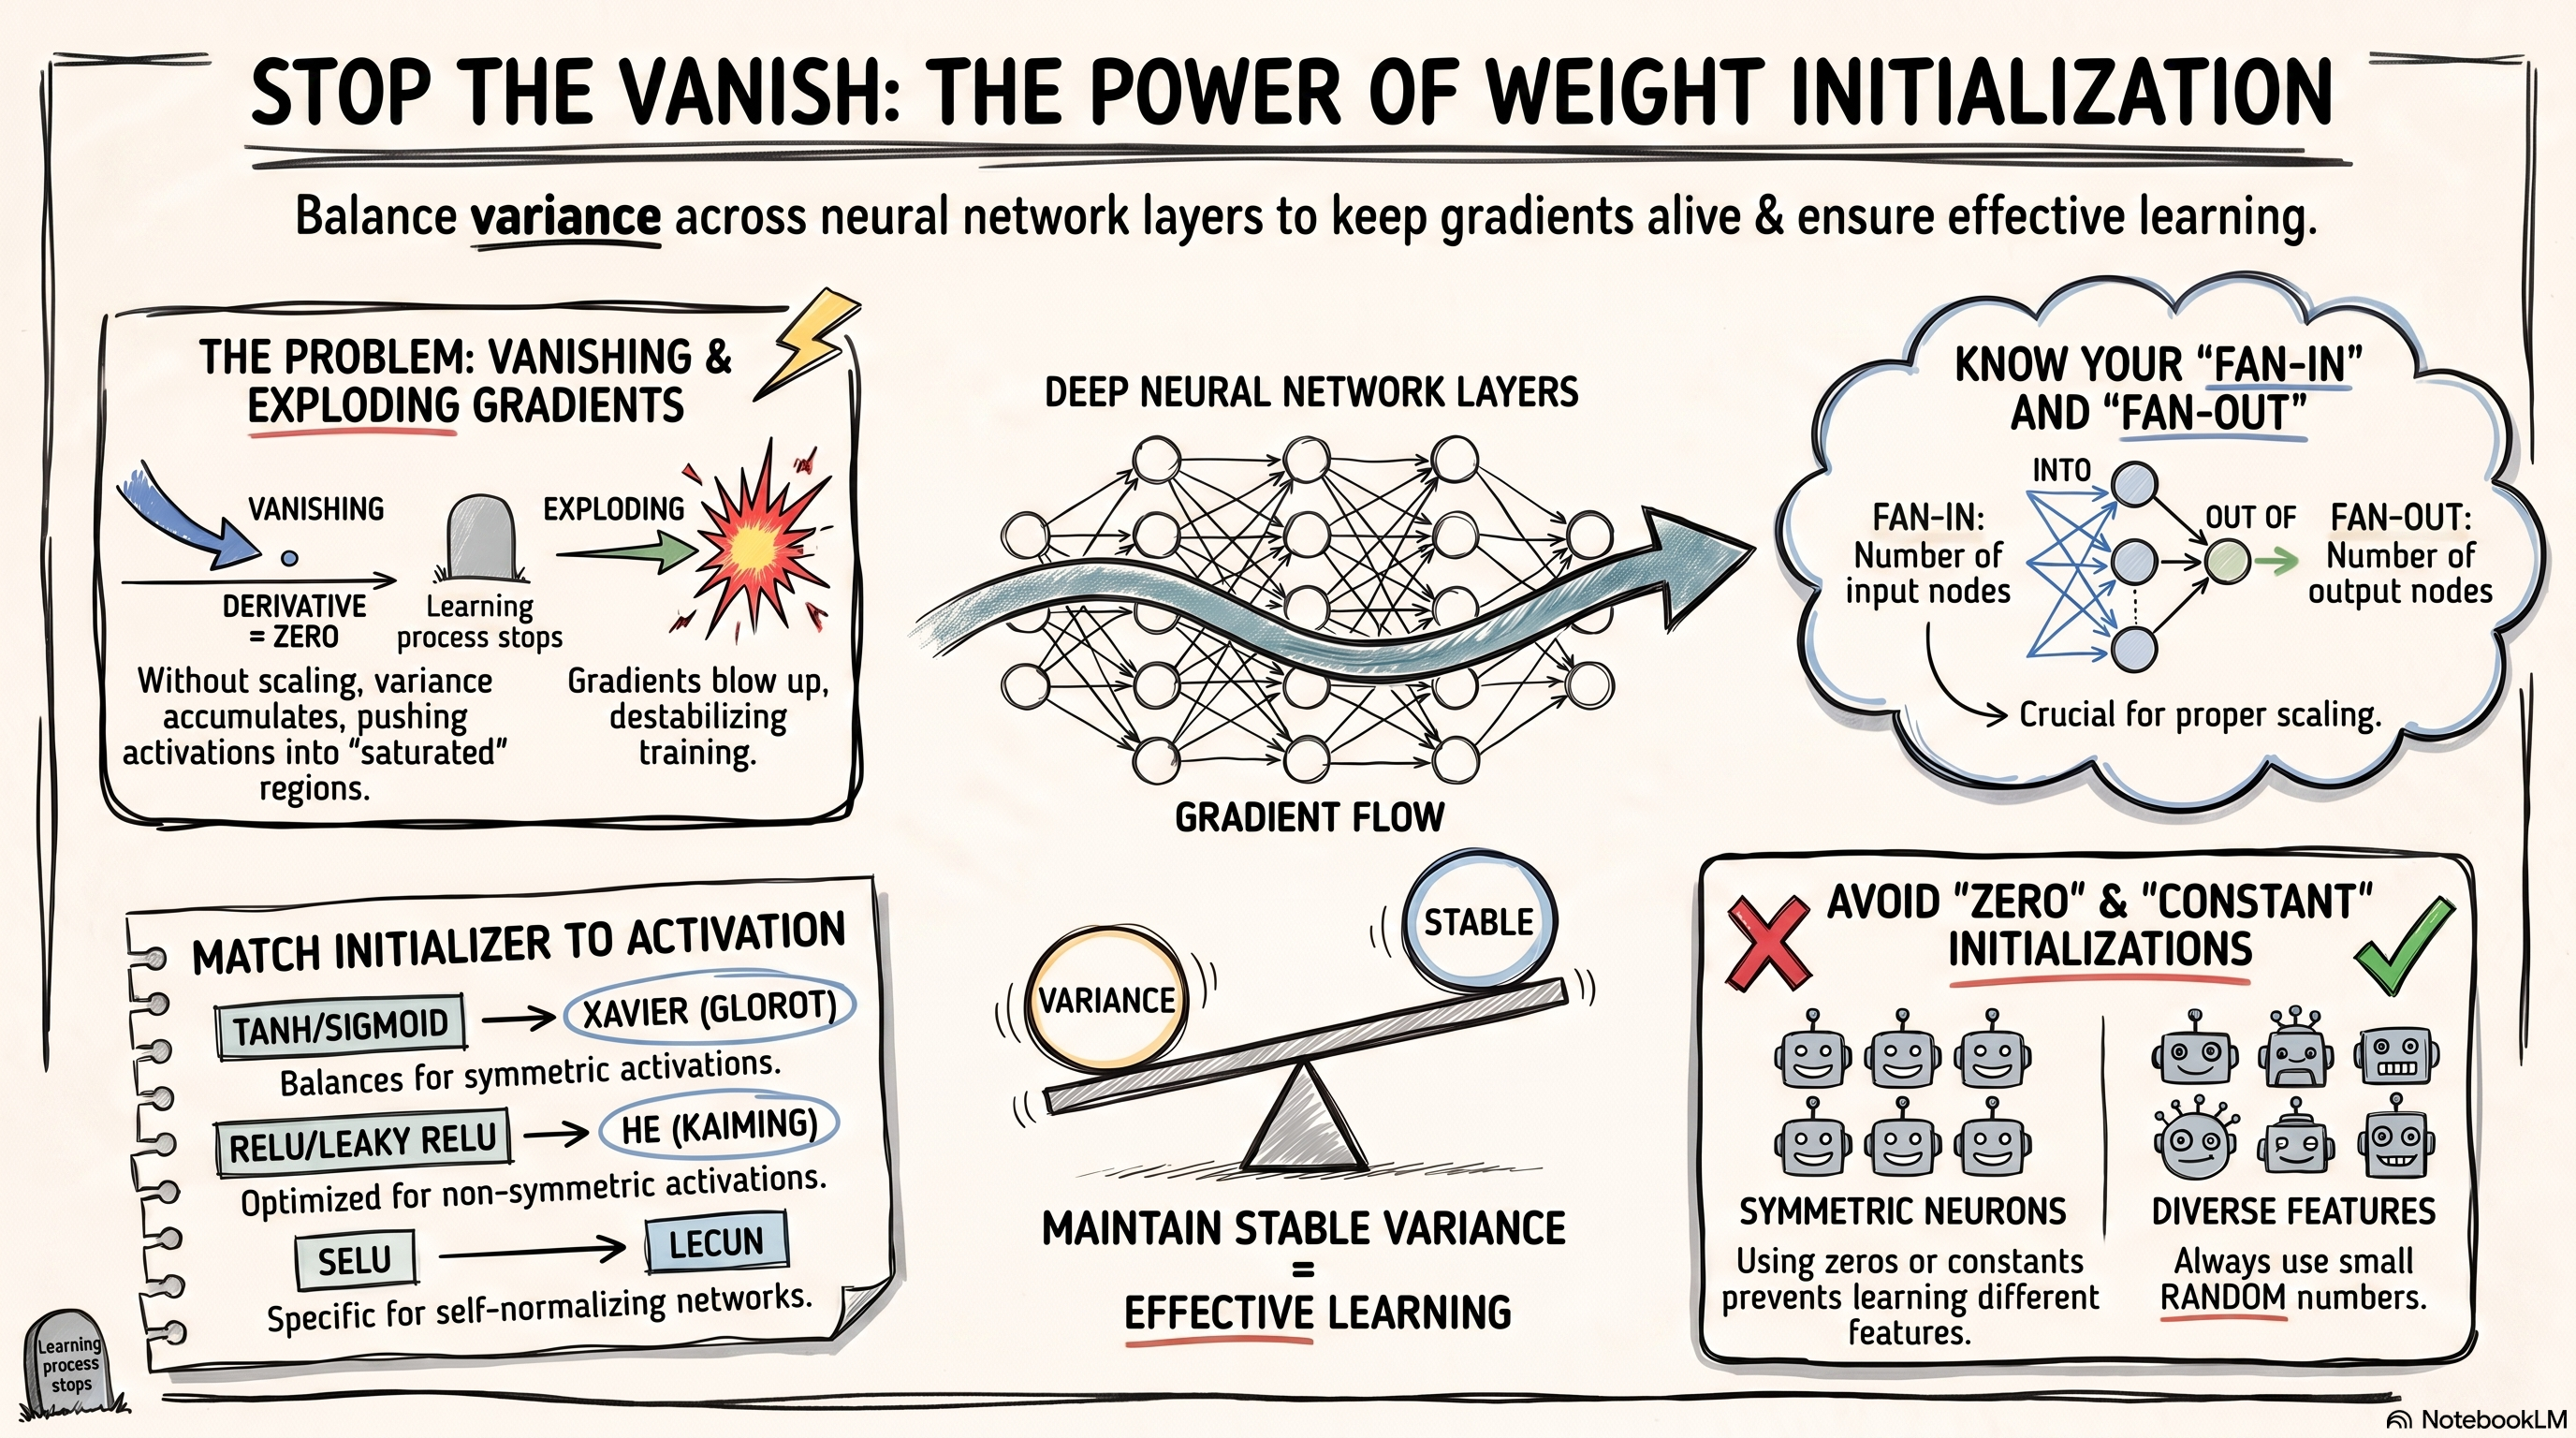
2010년 Xavier Glorot et al.에 의해 효과가 입증되면서 deep neural network를 효과적으로 학습시키기 위한 기본 기법으로 널리 사용되게 됨:
- "logistic activation function" + "normal distribution 초기화" 조합이
- 각 layer의 input/output node 수가 다르다는 구조적 특성 과 결합되면서,
- variance가 layer를 거칠수록 한쪽으로 누적/증폭되고, 이것이 결국 gradient를 죽이는 방향으로 이어짐.
참고 : Random variable의 곱과 variance
1. Variance가 커지는 메커니즘
- ANN의 한 layer output은 input들의 weighted sum에 activation function을 씌운 값임.
- forward flow에서는 output의 variance가 input node 개수(\(\text{fan}_{in}\))에 비례하여 커짐.
- backward flow에서는 gradient의 variance가 output node 개수(\(\text{fan}_{out}\))에 비례하여 커짐.
- 당시 관행이던 normal distribution 초기화는 이 \(\text{fan}_{in}\), \(\text{fan}_{out}\) 차이를 전혀 보정해주지 않음.
- 결과적으로 forward pass가 진행될수록(= layer를 통과할수록) output의 variance가 input의 variance보다 점점 커지는 방향으로 누적됨.
2. Variance 증가 → Gradient Vanishing으로 이어지는 경로
- variance가 누적되어 커지면, output layer에 가까운 layer일수록 logistic activation의 입력값이 매우 크거나 작은 값으로 몰리게 됨.
- 그 결과 logistic 출력이 0 또는 1 쪽으로 saturate(포화)됨.
- logistic의 saturated region에서는 derivative가 거의 0에 가까움.
- backward-pass는 이 derivative들을 차례로 곱해가며 lower layer로 전달하는 과정임.
- 시작부터 거의 0인 값을 곱해나가다 보니, 몇 layer만 지나도 gradient는 사실상 0이 되어버림. (Vanishing Gradient)
3. 또 다른 원인: Bias Shift
- variance 누적과는 별개로, logistic activation 자체의 출력 분포도 문제를 더함.
- logistic 출력은 mean이 0.5이고 항상 양수임. (참고로 normal distribution의 mean은 0임.)
- mean activation이 0이 아닌 unit은 다음 layer 입장에서 일종의 bias처럼 작용함.
- 이런 unit들의 출력이 서로 상쇄되지 않으면, 학습이 진행될수록 다음 layer의 unit들에 그 영향이 누적됨.
- 이를 bias shift 라 부름.
- bias shift는 mean activation이
- 0이 아닌 unit이 다음 layer에 bias처럼 작용하고,
- 이런 unit들이 서로 상쇄되지 않을 경우 다음 layer의 unit들에 누적되어 나타나는 효과를 가리키는 용어
- logistic의 bias shift는 앞서 설명한 variance 누적 문제를 더 악화시키는 방향으로 작용함.
- mean이 0에 가까운
tanh가 logistic보다 학습에 유리한 경우가 많음.
참고 : sigmoid
중요
ANN에서 weight initialization 관점에서 gradient vanishing을 막으려면 다음이 성립해야 한다.
- 각 layer를 거쳐도 variance는 변화가 없어야 한다.
- 이는 forward-flow 와 backward-flow 모두에서 성립해야 한다.
- 이를 위해선 layer의 input과 output이 동일한 variance를 가져야 한다.
\(\text{fan}_\text{in}\)과 \(\text{fan}_\text{out}\)이 같지 않을 경우 variance를 완전히 동일하게 만들기는 불가능하지만,
Xavier Glorot et al.은 일종의 좋은 타협안을 제시했고 성공을 거뒀다.
Glorot et al.이 제안한 weight initialization (이른바 Xavier/Glorot initialization)은
\(\text{fan}_{in}\), \(\text{fan}_{out}\)을 고려해
초기 weight의 scale을 조정함으로써 이 variance 누적을 완화하는 방향으로 설계됨.
핵심은 variance를 \(\text{fan}_\text{in}\) 과 \(\text{fan}_\text{out}\) 를 기반으로 조절하는 것이었음.
(사실 더 정확하게 애기하면 2nd raw moment 를 조절함)
사실 Yann LeCun et al. (1998) 도 비슷한 형태의 Weight Initialization을 제시했다.
이 외에 weight의 초기화에서 주의할 점들은 다음과 같음.
- weights는 모두 0으로 초기화되어선 안됨 (모두 0을 곱하면 같은 출력이 나오게 된다.)
- weights를 constant로 초기화해선 안됨 (모든 같은 gradient를 가지게 되어 layer내의 모든 neuron이 대칭적인 구조가 되버림).
- 때문에 작은 수의 random number로 초기화되어야 함 (값이 너무 클 경우 logistic function의 출력을 saturation시킴.)
- random이어야 하는 이유는 같은 layer 안의 neuron들이 서로 다른 weight를 가져야 하기 때문임.
- 참고로 초기화 분포 자체는 보통 mean이 0인 symmetric distribution을 사용해도 됨.
때문에 scale을 조절하지 않은 standard normal distribution, 즉 \(N(0, 1)\)로 초기화할 경우 activation 값이 쉽게 커지고 logistic function이 saturation 영역에 들어갈 수 있음.
- 즉, 문제가 되는 것은 normal distribution 자체가 아니라, fan-in/fan-out을 고려하지 않은 너무 큰 variance임.
- normal distribution의 variance인 1은 vanishing gradient의 관점에서 보면 작지 않은 variance임.
- 만약 0.01 정도로 줄인다면 좀더 나은 결과를 얻을 수 있음.
"Fan in" and "Fan out"
앞서 애기한 fan in과 fan out은 다음과 같다.
- \(\text{fan}_\text{in}\)
- layer에 들어오는 input node 수에 해당함 (=이전 layer의 neuron 수에 해당).
- \(\text{fan}_\text{out}\)
- layer에 들어오는 output node 수에 해당함.
Ex.: conv2d layer 에서 receptive field의 크기가 \(5 \times 5\)이고, input의 channel이 \(3\) 이고 output은 \(10\) 인 경우는 다음과 같음.
kernel_shape: \(5 \times 5 \times 3 \times 10\)- \(\text{fan}_\text{in}\) : \(5 \times 5 \times 3 = 75\)
- \(\text{fan}_\text{out}\) : \(5 \times 5 \times 10 = 250\)
Weight Initialization Methods
초기에 많이 애용된
- constant로 고정된 경우나
- Normal distribution (\(N(0,1)\))을 사용한 경우는,
오늘날 사용되지 않으며 다음의 방법들 이 주로 이용된다.
주의할 것은 activation function에 따라 좀더 적절한 initialization이 결정된다는 점임.
때문에 아래 표에서 궁합이 맞는 activation functions 가 같이 표기됨.
| Initialization | Activation functions | \(\sigma^2\) (Normal dist. , \(\mu=0\)) | [\(-a, a\)] (Uniform dist.) | Keras impl. |
|---|---|---|---|---|
| Yann LeCun 1998 | SELU | \(\sigma^2 = 1/\text{fan}_\text{in}\) | \(a=\sqrt{3\sigma^2}=\sqrt{\frac{3}{\text{fan}_\text{in}}}\) | lecun_normal,lecun_uniform |
| Xavier Glorot 2010 | None, tanh, sigmoid, softmax | \(\sigma^2 = 1/\text{fan}_\text{avg}\) | \(a = \sqrt{3\sigma^2}=\sqrt{\frac{3}{\text{fan}_\text{avg}}}\) | glorot_normal,glorot_uniform |
| Kaiming He 2015 | ReLU, Leaky ReLU, ELU, GELU, Mish | \(\sigma^2 = 2/\text{fan}_\text{in}\) | \(a = \sqrt{3\sigma^2} =\sqrt{\frac{6}{\text{fan}_\text{in}}}\) | he_normal,he_uniform |
- 위의 normal distribution들은 variance만 차이가 있을 뿐, 모두 mean=0임.
- Xavier Glorot et al.이 제안한 방식의 경우,
ReLU가 유행하기 전까지 가장 많이 사용되었으나 아쉽게도ReLU와는 잘 맞지 않는다는 결과들로 인해 Kaiming He et al. 의 방식이 제안됨.ReLU에서 0 이상의 값은 그대로 통과시키다보니 다시 \(\text{fan}_\text{in}\)만을 고려하면서 He의 방식에서는 coefficient를 조금 다르게 줌.ReLU계열들을 사용시 기본으로 사용됨.
- 참고로 LeCun의 방법과 가장 궁합이 맞는
SELU(Scaled Exponential Linear Unit)는 한참 뒤인 2017년에 제안됨.
다음의 값들의 수식적인 유도는 He initialization 을 예를 든 다음 문서를 참고할 것: He Initialization (Kaiming Intializationi) 유도
PyTorch에선
fan_out을fan_in대신 사용하는 He initialization으로 사용할 수 있음.
- 보통 netork가 매우 깊어서 backward pass에서 gradient의 vanishing/exploding이 더 큰 문제가 될 때
fan_out을 적용한다.- He et al. (2015) 논문에서도 forward/backward 어느 쪽을 기준으로 하든 결과(분산이 안정적으로 유지된다는 결론)는 점근적으로 동등하다고 언급하고 있음.
- PyTorch 의
torch.nn.init는 다음을 참고:torch.nn.init대표적인 예가
- torchvision의 ResNet 구현(수십~수백 layer)은
Conv2dlayer에 대해nn.init.kaiming_normal_(m.weight, mode="fan_out", nonlinearity="relu")를 사용함.- 개인적으론 작은 값이 되도록 선택하는 것을 선호함 (
fan_in과fan_out이 분모로 들어가므로 크기가 큰 쪽을 선택).
References
- Efficient BackProp. Yann LeCun et al.1998
- Delving Deep into Rectifiers: Surpassing Human-Level Performance on ImageNet Classification, Kaiming He et al., 2015
- ExcelsiorCJH's Chap11.1 - 심층 신경망 훈련 ****
- 갈아먹는 딥러닝 기초 [2] weight initialization ***
- Keras API Ref. : Layer weight initializers **
- Github : Keras Source Code: initializers.py