Categorical distribution에서 Cross entropy loss 유도
다음과 같은 cross entropy loss를 Categorical distribution에 기반한 NLL으로 유도해보자
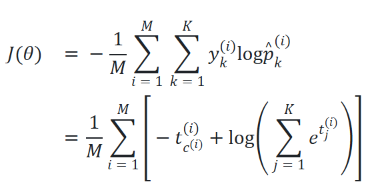
Multi-class Classification에서 정답의 확률 분포가 model 이 결과로 내놓는 predicted probability vector 를 parameter 로 갖는 Categorical distribution 을 따른다고 가정!
1. Categorical distribution
Categorical distribution 은 하나의 sample 이 K 개의 class 중 하나에 속하는 결과를 모델링함.
- 모델의 예측은 class 확률 vector 로, 관측된 정답은 one-hot vector 로 표현함.
- 이 확률분포의 Probability mass function 에서 정답 class 의 확률만 남게 됨에 유의할 것.
우선, 모델이 예측하는 각 class 의 확률을 하나의 vector 로 정의함 (모델의 예측 확률이라는 의미를 표시하기 위해 hat 을 붙임).
이 vector 가 probability distribution 이므로 각 성분이 0 이상이고, 모든 성분의 합이 1이 성립.
- \(\hat{\mathbf{p}}\): 모델이 예측한 class 확률 vector 임.
- \(\hat p_k\): class \(k\) 의 예측 확률임.
- K: class 의 총개수임.
- k: class index 임. 1부터 \(K\)까지의 값을 가짐.
위에서 나타낸 probability distribution vector 는 가능한 모든 class 에 확률을 부여할 수 있음.
이는 모델이 예측하는 경우엔 일반적이며 아직 학습이 제대로 이루어지지 않은 초기에서 각 class의 확률들의 차이가 크지 않을 수 있음.
이와 달리, 관측된 정답(=target)은 하나의 class 이므로 정답 class 의 성분만 1인 one-hot vector 로 표현됨.
(multi-class classification 테스크를 다루고 있기 때문임).
다음은 이를 수식으로 표현한 것임(Hard Target이라고도 불림)
- \(\mathbf{y}\): 관측된 정답의 one-hot vector 임.
- \(y_k\): class k 에 대한 indicator 임. 정답 class 이면 1, 나머지는 0임.
- \(K\): class 의 총개수임.
- \(k\): class index 임. 1부터 \(K\)까지의 값을 가짐.
- \(c\): 정답 class index 임.
One-hot vector 의 성분을 각 class 확률의 exponent 로 사용하면, 정답 class 의 확률만 그대로 남고 나머지 항은 1이 됨.
따라서 다음 probability mass function 은 관측된 정답이 발생할 확률을 나타냄.
위 식은 모든 class 에 대한 곱으로 표현되었으나 실제 결과는 정답 class 에 부여한 확률 하나 를 의미 (exponent가 1인 경우만 의미를 가짐).
이 확률을 모델의 parameter 에 대한 함수로 해석하면 다음 절의 likelihood 로 연결됨.
- \(\mathbf Y\): class 결과를 one-hot vector 로 나타내는 random vector 임.
- \(\mathbf{y}\): 관측된 정답의 one-hot vector 임.
- \(\hat{\mathbf{p}}\): 모델이 예측한 class 확률 vector 임.
- \(\hat p_k\): class \(k\) 의 예측 확률임.
- \(y_k\): 정답 class 이면 1, 나머지는 0인 indicator 임.
- \(K\): class 의 총개수임.
- \(k\): class index 임.
- \(c\): 정답 class index 임.
- \(\hat p_c\): 정답 class 의 예측 확률임.
- \(P\): probability 를 나타냄.
- \(\mid\): 주어진 조건을 나타냄.
- \(\prod_{k=1}^{K}\): class index 1부터 \(K\)까지의 항을 모두 곱하는 연산임.
참고
- Random vector:
- 성분이 random variable 인 vector 임.
- 현재 식의 \(\mathbf Y\)는 관측 결과에 따라 어느 성분이 1인지 달라지는 one-hot random vector 임.
- Probability vector:
- 각 성분이 확률이며, 모든 성분이 0 이상이고 합이 1인 vector 임.
- 위의 식의 \(\hat{\mathbf{p}}\)가 해당함.
- Probability distribution vector 라고도 표현할 수 있으나, 보통 probability vector 라고 부름.
관측된 one-hot vector \(\mathbf{y}\)는 random vector 이며,
동시에 정답 class 에 확률 1을 부여하는 probability vector 로 해석할 수 있음.
앞의 indicator 라는 용어가 수학에서 쓰이는 의미는 다음을 참고: indicator function 이란
2. Negative log-likelihood
관측된 입력과 정답을 고정(dataset이 주어진 경우를 의미)하고
모델의 parameter 에 대한 함수로 표현하면 likelihood 가 됨.
Likelihood 를 최대화하는 것은 negative log-likelihood 를 최소화하는 것과 동등함.
- Likelihood가 각 이벤트가 독립인 경우 확률간의 곱으로 표현되므로
- 여기에 Logarithm 을 적용하면 확률의 곱이 log probability 의 합으로 바뀜.
앞 절에서는 모델이 입력 sample 에 대해 출력한 class 별 예측 확률 중, 실제 정답 label 에 해당하는 class 의 확률 을 categorical probability mass function 으로 표현함.
이 예측 확률은 입력과 모델의 parameter 에 의해 결정됨.
따라서 입력 sample 과 실제 정답 label 을 고정한 상태에서 parameter 를 바꾸면, 모델이 정답 class 에 부여하는 확률이 달라짐.
- parameter 가 독립변수라고 생각!
- parameter 를 독립변수 로 처리하고, input \(\mathbf{x}\)와 label \(\mathbf{y}\) 가 고정된 함수가 likelihood!
다음 식은 "모델이 정답 class 에 부여하는 확률" 을 parameter 에 대한 함수인 likelihood 로 표현한 것임:
- \(\boldsymbol{\theta}\): 모델의 weight, bias 등을 포함하는 parameter vector 임.
- \(\mathbf{x}\): 입력 sample 의 feature vector 임.
- \(\mathbf{y}\): 관측된 정답의 one-hot vector 임.
- \(\mathbf Y\): class 결과를 one-hot vector 로 나타내는 random vector 임.
- \(\mathcal L(\boldsymbol{\theta}\mid\mathbf{x},\mathbf{y})\): 입력과 정답을 고정하고 parameter 의 함수로 표현한 likelihood 임.
- \(p(\mathbf{y}\mid\mathbf{x};\boldsymbol{\theta})\): 입력과 parameter 가 주어졌을 때 관측된 정답에 부여하는 probability mass 임.
- \(\hat{\mathbf{p}}(\mathbf{x};\boldsymbol{\theta})\): 입력과 parameter 로 결정되는 predicted probability vector 임.
- \(\hat p_k(\mathbf{x};\boldsymbol{\theta})\): class \(k\) 의 예측 확률임.
- \(y_k\): 정답 class 이면 1, 나머지는 0인 indicator 임.
- \(K\): class 의 총개수임.
- \(k\): class index 임.
위 likelihood 가 커진다는 것은 모델이 정답 class 에 더 높은 확률을 부여한다는 의미임.
이를 최소화하는 loss 로 표현하기 위해 negative logarithm 을 적용 함.
다음 전개에서는
- log 의 곱셈 법칙과 거듭제곱 법칙을 적용하고,
- 곱의 log 는 log 의 합으로 바꾸고, log 안의 exponent 는 log 앞의 계수로 꺼냄.
- 마지막에 one-hot 정답의 성질(정답 class 의 성분만 1이고, 나머지 성분은 0)을 사용함.
- Likelihood 와 loss 를 구분하기 위해
- likelihood 는 대문자 calligraphic \(\mathcal L\),
- 단일 sample 의 loss 는 소문자 ell \(\ell\) 로 표기함.
- \(\boldsymbol{\theta}\): 모델의 weight, bias 등을 포함하는 parameter vector 임.
- \(\mathbf{x}\): 입력 sample 의 feature vector 임.
- \(\hat{\mathbf{p}}(\mathbf{x};\boldsymbol{\theta})\): 입력과 모델의 parameter 로 결정되는 예측 확률 vector 임.
- \(\hat p_k(\mathbf{x};\boldsymbol{\theta})\): class k 의 예측 확률임. 이후 전개에서는 \(\hat p_k\)로 줄여 표기함.
- \(p(\mathbf{y}\mid\mathbf{x};\boldsymbol{\theta})\): 주어진 입력과 현재 parameter 에서 모델이 실제 정답 class 에 부여하는 확률임.
- \(\mathcal L(\boldsymbol{\theta}\mid\mathbf{x},\mathbf{y})\): 입력과 실제 정답 label 을 고정하고 parameter 의 함수로 표현한 likelihood 임.
- \(\ell_{\mathrm{NLL}}\): 단일 sample 의 negative log-likelihood 임.
- \(\log\): natural logarithm 임.
따라서 단일 sample 의 NLL 은 정답 class 에 부여한 확률의 negative logarithm 임.
- 정답 class 의 확률이 1에 가까워질수록 loss 는 0에 가까워지고, 0에 가까워질수록 loss 는 커짐.
- 전개 과정에서 얻은 가중합 형태가 다음 절의 cross entropy 정의와 일치함.
3. Cross entropy 와의 관계
Cross entropy 는 정답 distribution 에 따라 모델의 negative log probability 를 가중 평균한 값임.
- 정답 distribution이 hard target인 경우, 정답 요소만 1 이고 나머진 0이라는 점을 기억.
- 이 요소들을 weight로 삼아서 계산한 weighted mean 이 Cross entropy임.
Cross entropy 는 실제 probability distribution (=정답 distribution) 에서 발생하는 결과를
예측 probability distribution (model의 출력) 으로 표현할 때 필요한 평균 정보량을 나타내는 척도로
ML 등에선 확률분포의 실제와 예측 간의 차이 를 나타내는데 이용됨
Cross entropy에 실제 One-hot 정답을 대입하면 결국 정답 class 의 항만 남음.
결국 categorical distribution 에서 유도한 NLL 은 cross entropy loss 와 동일함. 즉, one-hot 정답 vector 를 정답 class 에 확률 1을 부여하는 정답 probability distribution 로 생각하면 됨.
각 class 의 negative log probability 에 정답 distribution 의 해당 확률을 곱하여 합하면 다음 cross entropy \(H(\mathbf{y},\hat{\mathbf{p}})\) 를 얻음.
- \(\mathbf{y}\): 정답 class 에 확률 1을 부여하는 one-hot target distribution 임.
- \(\hat{\mathbf{p}}\): 모델이 예측한 class 확률 vector 임.
- \(H(\mathbf{y},\hat{\mathbf{p}})\): target distribution 과 예측 distribution 사이의 cross entropy 임.
- \(y_k\): 정답 class 이면 1, 나머지는 0인 indicator 임.
- \(\hat p_k\): class k 의 예측 확률임.
- \(K\): class 의 총개수임.
- \(k\): class index 임.
위 식은 앞 절에서 likelihood 에 negative logarithm 을 적용하여 얻은 식과 동일함.
또한 one-hot 정답에서는 정답 class 의 가중치만 1이므로, NLL 과 cross entropy loss 의 관계를 다음과 같이 정리할 수 있음.
- \(\ell_{\mathrm{NLL}}\): 단일 sample 의 negative log-likelihood 임.
- \(\ell_{\mathrm{CE}}\): 단일 sample 의 cross entropy loss 임.
- \(H(\mathbf{y},\hat{\mathbf{p}})\): one-hot target distribution 과 예측 distribution 사이의 cross entropy 임.
- \(\mathbf{y}\): 정답의 one-hot vector 임.
- \(\hat{\mathbf{p}}\): 모델이 예측한 class 확률 vector 임.
- \(y_k\): 정답 class 이면 1, 나머지는 0인 indicator 임.
- \(\hat p_k\): class k 의 예측 확률임.
- \(\hat p_c\): 정답 class 의 예측 확률임.
- \(K\): class 의 총개수임.
- \(k\): class index 임.
- \(c\): 정답 class index 임.
즉, categorical likelihood 를 최대화하는 학습 과 one-hot 정답에 대한 cross entropy 를 최소화하는 학습 은 같은 목적을 가짐.
- \(H(\mathbf{y},\hat{\mathbf{p}})\): 정답 distribution 과 예측 distribution 사이의 cross entropy 임.
- \(\ell_{\mathrm{CE}}\): 단일 sample 의 cross entropy loss 임.
일반적인 cross entropy 정의에서는 target distribution 을 \(\mathbf{p}\), model distribution 을 \(\mathbf{q}\)로 표기하기도 함.
- 이 표기와 연결하려면 target distribution \(\mathbf{p}\)에 one-hot 정답 vector 를,
- model distribution \(\mathbf{q}\)에 모델의 predicted probability vector 를 대입하면 됨.
여기서 hat 이 없는 \(\mathbf{p}\) 는 일반적인 cross entropy 정의의 target distribution 이고,
hat 이 있는 \(\mathbf{p}\) 는 모델의 예측 distribution 임.
두 표기에서 distribution 의 역할을 구분하면 같은 cross entropy 를 나타냄을 확인할 수 있음.
4. Logits 로 표현
ML의 multi-class classification에선
- 모델의 logits 에 softmax 를 적용하여 class 확률을 구함.
- 이를 cross entropy loss 에 대입하면 정답 class 의 logit 과 전체 logits 의 log-sum-exp 로 표현됨.
여러 sample 의 정답이 입력과 parameter 가 주어졌을 때 조건부로 독립 이라고 가정하면,
- 모든 sample 의 입력과 모델의 parameter 를 고정하면,
- 다른 sample 의 정답 label 을 알아도 해당 sample 의 class 확률이 달라지지 않음을 의미.
- 단순히 “정답들이 서로 무관함”을 넘어서서, 입력과 parameter 가 주어졌다는 조건 아래에서 독립임
이 경우, 전체 likelihood 는 sample 별 likelihood 의 곱임.
전체 NLL 을 sample 개수로 나누면 평균 cross entropy loss 가 됨.
Logits 자체는 음수가 될 수 있으며, 전체 합이 1이라는 조건도 없음.
따라서 logits을 categorical distribution 의 확률로 사용하기 위해 softmax 를 적용함.
각 logit 의 exponential 을 전체 exponential 의 합으로 나누면, 모든 성분이 양수이고 합이 1인 확률 vector 를 얻음.
여기선 logit score 를 \(t\)로 나타내지만, \(z\)로 표기하는 경우도 많음.
Latent score(잠재 점수)는
직접 관측되지 않는 특성이나 성향을 나타내기 위해, 관측된 데이터로부터 model 이 추정하거나 계산한 수치를 가리키는 용어.
많이 사용되는 symbol이 \(z\)임.softmax 를 통해 각 class 의 확률로 변환되기 전의 logit을 일종의 latent score로 해석하기도 함. 여기서 직접 관측되지 않는다는 것은 해당 score 가 데이터에 관측값으로 주어지는 것이 아니라, model 을 통해 계산된다는 의미임.
- \(\hat p_k\): class \(k\) 의 예측 확률임.
- \(t_k\): class \(k\) 의 logit 임. softmax 적용 전 모델의 출력값임.
- \(t_j\): class \(j\) 의 logit 임.
- \(K\): class 의 총개수임.
- \(k\): 예측 확률을 구하려는 class index 임.
- \(j\): 모든 class 에 대해 합산하기 위한 index 임.
- \(e\): natural logarithm 의 밑인 Euler’s number 임.
위 softmax 식에서
정답 class 에 해당하는 예측 확률을 구하고
이를 단일 sample 의 cross entropy loss 에 대입하고
이후 분수의 log 를 분자의 log 와 분모의 log 의 차로 분리하여 정리하면,
다음과 같이 loss 를 정답 class 의 logit 과 전체 class 의 logits 로 표현 할 수 있음:
- \(\ell_{\mathrm{CE}}\): 단일 sample 의 cross entropy loss 임.
- \(\hat p_c\): 정답 class 의 예측 확률임.
- \(t_c\): 정답 class 의 logit 임.
- \(t_j\): class j 의 logit 임. softmax 적용 전 모델의 출력값임.
- \(c\): 정답 class index 임.
- \(j\): 모든 class 에 대해 합산하기 위한 index 임.
- \(K\): class 의 총개수임.
- \(e\): 자연로그의 밑인 Euler’s number 임.
- \(\log\): natural logarithm 임.
위 식에서
- 정답 class 의 logit 은 첫 번째 항에 직접 포함되고,
- 모든 class 의 logits 는 log-sum-exp 항에 포함됨.
따라서 loss 는 정답 class 의 logit 이 다른 class 의 logits 에 비해 얼마나 큰지에 의해 결정됨.
지금까지는 단일 sample 에 대해서만 구한 식들이며,
실제 ML의 학습에서 사용한다면
여러 sample 을 학습하므로
sample 별 likelihood 를 결합해야 loss를 구함.
이제 전체 dataset 에 대한 likelihood 를 구해보자.
- 각 sample 의 예측 확률과 정답 indicator 에 sample index 를 추가함.
- Sample index 는 괄호가 있는 위첨자로 나타내고, class index 는 아래첨자로 나타냄.
- 입력과 parameter 가 주어졌을 때 정답들이 조건부로 독립 이라는 가정에 따라,
- 각 sample 의 categorical likelihood 를 곱 함.
- \(\mathcal L_M(\boldsymbol{\theta})\): 전체 \(M\) 개 sample 에 대한 likelihood 임.
- \(\mathcal L(\boldsymbol{\theta}\mid\mathbf{x}^{(i)},\mathbf{y}^{(i)})\): \(i\) 번째 sample 에 대한 likelihood 임.
- \(\boldsymbol{\theta}\): 모든 sample 에 공통으로 적용되는 모델의 parameter vector 임.
- \(\mathbf{x}^{(i)}\): \(i\) 번째 sample 의 입력 feature vector 임.
- \(\mathbf{y}^{(i)}\): \(i\) 번째 sample 의 정답 one-hot vector 임.
- \(\hat p_k^{(i)}\): \(i\) 번째 sample 의 class \(k\) 예측 확률임.
- \(y_k^{(i)}\): \(i\) 번째 sample 의 정답 class 가 \(k\)이면 \(1\), 나머지는 0인 indicator 임.
- \(M\): sample 의 총개수임.
- \(K\): class 의 총개수임.
- \(i\): sample index 임. 위첨자 \((i)\)는 거듭제곱이 아닌 sample 구분을 나타냄.
- \(k\): class index 임.
위 식에서
- 안쪽 곱은 하나의 sample 에서 정답 class 의 확률을 선택하고,
- 바깥쪽 곱은 모든 sample 의 정답 확률을 결합함.
이 전체 likelihood 에 negative logarithm 을 적용하면 sample 별 loss 의 합이 됨.
이를 sample 개수로 나누어 sample 당 평균 loss 를 정의함.
평균 loss 는 모델의 parameter 에 대한 objective function 이므로 \(J\)로 표기함.
- \(J(\boldsymbol{\theta})\): 전체 \(M\) 개 sample 의 평균 cross entropy loss 임.
- \(\mathcal L_M(\boldsymbol{\theta})\): 전체 \(M\) 개 sample 에 대한 likelihood 임.
- \(\boldsymbol{\theta}\): 모델의 parameter vector 임.
- \(\hat p_k^{(i)}\): \(i\) 번째 sample 의 class \(k\) 예측 확률임.
- \(y_k^{(i)}\): \(i\) 번째 sample 의 정답 class 가 \(k\)이면 1, 나머지는 0인 indicator 임.
- \(M\): sample 의 총개수임.
- \(K\): class 의 총개수임.
- \(i\): sample index 임.
- \(k\): class index 임.
- \(\log\): natural logarithm 임.
따라서 평균 cross entropy loss 는 각 sample 의 정답 class 에 대한 negative log probability 를 계산한 뒤 평균한 값임.
Sample 개수가 고정되어 있으면, 전체 NLL 을 최소화하는 것과 평균 cross entropy loss 를 최소화하는 것은 동일한 최적화 목적을 가짐.
참고: Logits 표현과 평균 cross entropy 의 동등성
마지막 식의 예측 확률을 softmax 로 표현하면, sample 별 logits 로 계산한 loss 의 평균과 동일함을 확인할 수 있음.
먼저 각 sample 의 class 확률을 해당 sample 의 logits 로 나타냄.
- \(\hat p_k^{(i)}\): \(i\) 번째 sample 의 class \(k\) 예측 확률임.
- \(t_k^{(i)}\): \(i\) 번째 sample 의 class \(k\) 에 대한 logit 임. softmax 적용 전 모델의 출력값임.
- \(t_j^{(i)}\): \(i\) 번째 sample 의 class \(j\) 에 대한 logit 임.
- \(K\): class 의 총개수임.
- \(i\): sample index 임.
- \(k\): 예측 확률을 구하려는 class index 임.
- \(j\): 모든 class 에 대해 합산하기 위한 index 임.
- \(e\): 자연로그의 밑인 Euler’s number 임.
위 softmax 표현을 평균 cross entropy 식에 대입함.
Log 의 나눗셈 법칙을 적용하면 각 class 의 logit 과 해당 sample 의 log-sum-exp 항으로 분리됨.
Log-sum-exp 항은 같은 sample 내에서 class index \(k\) 에 무관하므로,
\(k\) 에 대한 합 밖으로 꺼낼 수 있음.
또한 one-hot 정답에서는 성분의 합이 1이고, logits 의 가중합에는 정답 class 의 logit 만 남음.
이 두 성질을 앞의 전개에 적용하면, 평균 cross entropy 를 sample 별 정답 logit 과 log-sum-exp 로 표현할 수 있음.
- \(J(\boldsymbol{\theta})\): 전체 \(M\) 개 sample 의 평균 cross entropy loss 임.
- \(\boldsymbol{\theta}\): 모델의 parameter vector 임.
- \(y_k^{(i)}\): \(i\) 번째 sample 의 정답 class 가 \(k\)이면 1, 나머지는 0인 indicator 임.
- \(\hat p_k^{(i)}\): \(i\) 번째 sample 의 class \(k\) 예측 확률임.
- \(c^{(i)}\): \(i\) 번째 sample 의 정답 class index 임.
- \(t_{c^{(i)}}^{(i)}\): \(i\) 번째 sample 의 정답 class 에 대한 logit 임.
- \(t_j^{(i)}\): \(i\) 번째 sample 의 class \(j\) 에 대한 logit 임.
- \(M\): sample 의 총개수임.
- \(K\): class 의 총개수임.
- \(i\): sample index 임.
- \(k, j\): class index 임.
- \(e\): 자연로그의 밑인 Euler’s number 임.
- \(\log\): natural logarithm 임.
대괄호 안은 앞서 4절에서 유도한 단일 sample 의 logits 기반 cross entropy loss 임.
따라서 마지막의 평균 cross entropy 식은 logits 로 표현한 단일 sample 의 loss 를 모든 sample 에 대해 평균한 식 과 동일함.